O que é um gateway de API de IA? Roteamento e uso
Saiba como um gateway de API de IA centraliza autenticação, acesso a modelos, roteamento, contingência, registros de uso e custos sem ocultar os limites de cada protocolo.
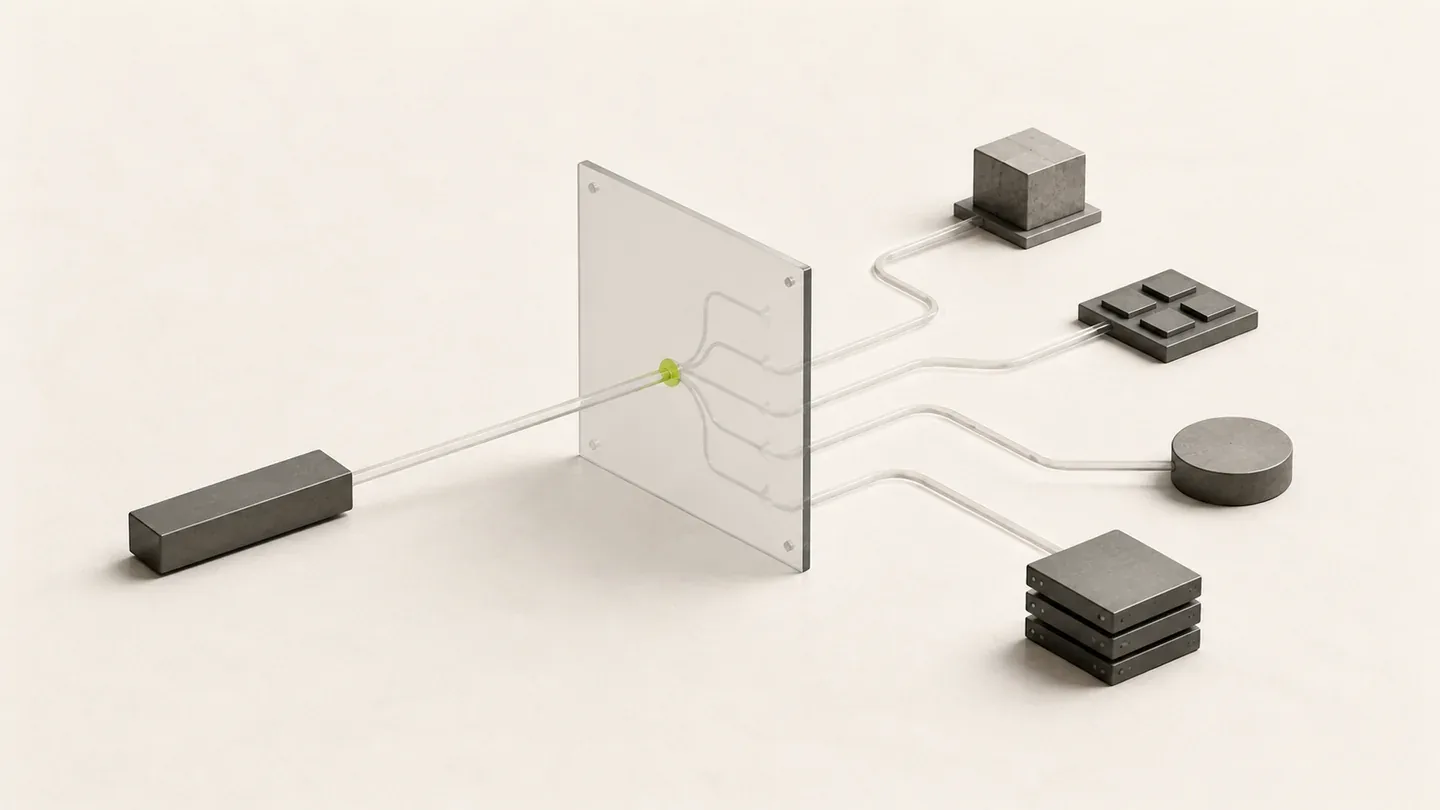
Um gateway de API de IA é uma fronteira de serviço entre uma aplicação e um ou mais backends de modelos. A aplicação envia uma solicitação ao gateway; o gateway aplica a autenticação e a política de acesso, seleciona uma rota elegível para o modelo solicitado, encaminha a solicitação e registra o resultado.
Essa definição é mais útil do que dizer “uma API para todos os modelos”. Um gateway pode centralizar as partes que devem ser consistentes, mas não faz com que todos os modelos ou provedores ofereçam suporte ao mesmo protocolo, às mesmas ferramentas, aos mesmos tipos de entrada ou ao mesmo perfil de latência.
Onde fica um gateway de API de IA
Um caminho típico de solicitação tem seis etapas:
| Etapa | Responsabilidade |
|---|---|
| Cliente | Escolhe o modelo, o protocolo, a entrada e o modo de streaming |
| Endpoint compatível | Aceita o formato de comunicação selecionado, como Chat Completions ou Responses |
| Política da chave de API | Verifica o acesso da conta, a cota, a expiração, os limites de modelos, as regras de IP e a configuração de roteamento |
| Rota do modelo | Seleciona um grupo de modelos e um canal elegíveis sem alterar o contrato solicitado |
| Backend do modelo | Executa a solicitação e retorna a saída específica do protocolo |
| Registro de uso | Associa status, modelo, grupo, tokens, tempos e custo à solicitação |
No Modelflare, a URL base pública é https://modelflare.dev/v1. Os clientes podem usar endpoints compatíveis enquanto a disponibilidade dos modelos, o suporte a protocolos e os preços atuais continuam acessíveis em Modelos e preços.
O que um gateway pode centralizar
Autenticação e política de chaves
As aplicações usam uma chave de API do Modelflare em vez de colocar credenciais de vários provedores em cada implantação. É possível criar chaves separadas para produção, desenvolvimento, agentes e automação, de modo que cada carga de trabalho tenha sua própria cota, expiração, acesso a modelos, regras de IP e política de roteamento.
Descoberta de modelos
A lista autenticada de modelos mostra os IDs de modelos disponíveis para a chave atual:
curl -sS https://modelflare.dev/v1/models \
  -H "Authorization: Bearer $MODELFLARE_API_KEY"
Isso é uma verificação de acesso, não uma promessa de compatibilidade universal. Um modelo retornado ainda precisa oferecer suporte ao endpoint e aos recursos usados pelo cliente.
Roteamento e contingência
Uma chave de API comum pode usar um grupo de modelos principal e grupos de contingência ordenados. Uma chave de API inteligente (Smart API Key) avalia os grupos concretos disponíveis para a conta de acordo com sua estratégia de roteamento. Nos dois casos, o roteamento escolhe onde o modelo solicitado é atendido; ele não deve substituir silenciosamente esse modelo por outro.
Para o design em produção, consulte Roteamento confiável de API de IA.
Visibilidade de uso e custo
Um gateway pode associar a solicitação concluída ao modelo e ao grupo selecionados. Os registros de uso do Modelflare mostram o status da solicitação, o uso de tokens, os tempos de resposta e o custo, para que um operador possa investigar uma solicitação específica em vez de fazer estimativas a partir de um total mensal. As camadas de contabilização são descritas em Rastreamento de custos de API de IA.
O que continua específico de cada modelo e protocolo
Um gateway de API de IA não elimina o contrato do provedor. Verifique estes limites separadamente:
- Suporte a endpoints: um modelo pode oferecer suporte a Chat Completions, Responses, Anthropic Messages, solicitações no estilo Gemini ou apenas a parte deles.
- Eventos de streaming: chunks do Chat Completions e eventos do Responses são contratos de cliente diferentes.
- Ferramentas e saída estruturada: os schemas e os tipos de ferramentas suportados podem variar conforme o modelo e o provedor.
- Entrada multimodal: imagens, áudio, arquivos e outras entradas exigem suporte explícito do modelo e do endpoint.
- Campos específicos do provedor: alguns endpoints compatíveis repassam intencionalmente controles privados, em vez de traduzi-los.
- Latência e limites: a disponibilidade de uma rota não faz com que todos os backends tenham o mesmo tempo até a primeira saída ou o mesmo limite de solicitações.
A migração mais segura começa pelo Guia de API compatível com OpenAI e testa exatamente os recursos usados pela aplicação.
Uma avaliação prática de gateway
Avalie um gateway com a carga de trabalho real, e não com um único prompt curto:
- Crie uma chave de API dedicada com a cota e a política de roteamento pretendidas.
- Consulte /v1/models e selecione um modelo visível para essa chave.
- Confirme o formato de API suportado no catálogo atualizado.
- Envie uma solicitação sem streaming e guarde o status retornado.
- Teste separadamente streaming, ferramentas, saída estruturada e entrada multimodal, quando necessário.
- Revise o registro de uso resultante: modelo, grupo, tokens, tempos e custo.
- Teste o caminho de contingência sem alterar o modelo ou o protocolo solicitado.
- Repita com um tamanho de contexto representativo e com os timeouts reais do cliente antes da migração para produção.
Quando um gateway é uma boa escolha
Um gateway de API de IA é útil quando uma equipe precisa de gerenciamento consistente de chaves, acesso a várias famílias de modelos, política de roteamento explícita, registros de uso centralizados ou uma fronteira de integração estável para agentes e aplicações.
Uma integração direta com o provedor ainda pode ser adequada quando uma aplicação depende de um recurso exclusivo do provedor que não tem contrato compatível no gateway, ou quando a equipe quer, intencionalmente, cuidar ela mesma das credenciais do provedor, do roteamento, da liquidação e do diagnóstico.
A decisão não é “gateway ou provedor” em abstrato. A questão é se o gateway preserva exatamente o protocolo e os recursos de que a carga de trabalho precisa, reduzindo ao mesmo tempo a complexidade operacional de acesso, roteamento e evidências.
Perguntas frequentes
Um único gateway significa que todos os modelos usam o mesmo formato de solicitação?
Não. Um gateway pode expor vários formatos compatíveis, mas o cliente, o endpoint, o modelo e o provedor ainda precisam concordar em um único contrato. Consulte o catálogo antes de mudar uma solicitação existente entre Chat Completions e Responses.
A contingência escolhe automaticamente outro modelo?
Os grupos de contingência do Modelflare são rotas para o modelo solicitado. Eles não são uma instrução para substituir o modelo por outro qualquer. Cada grupo candidato precisa expor o mesmo modelo e os mesmos recursos de protocolo exigidos pela solicitação.
O que deve ser medido antes da produção?
Meça o sucesso da autenticação, o acesso aos modelos, a saída sem streaming, a primeira saída efetiva em streaming, o tempo total de resposta, o uso, o custo e o comportamento em falhas. Um prompt de verificação de integridade bem-sucedido, por si só, não comprova a compatibilidade em produção.