AI API ゲートウェイとは?ルーティングと使用量管理
AI API ゲートウェイが、プロトコルの境界を隠すことなく、認証、モデルへのアクセス、ルーティング、フォールバック、利用記録、コストを一元化する仕組みを解説します。
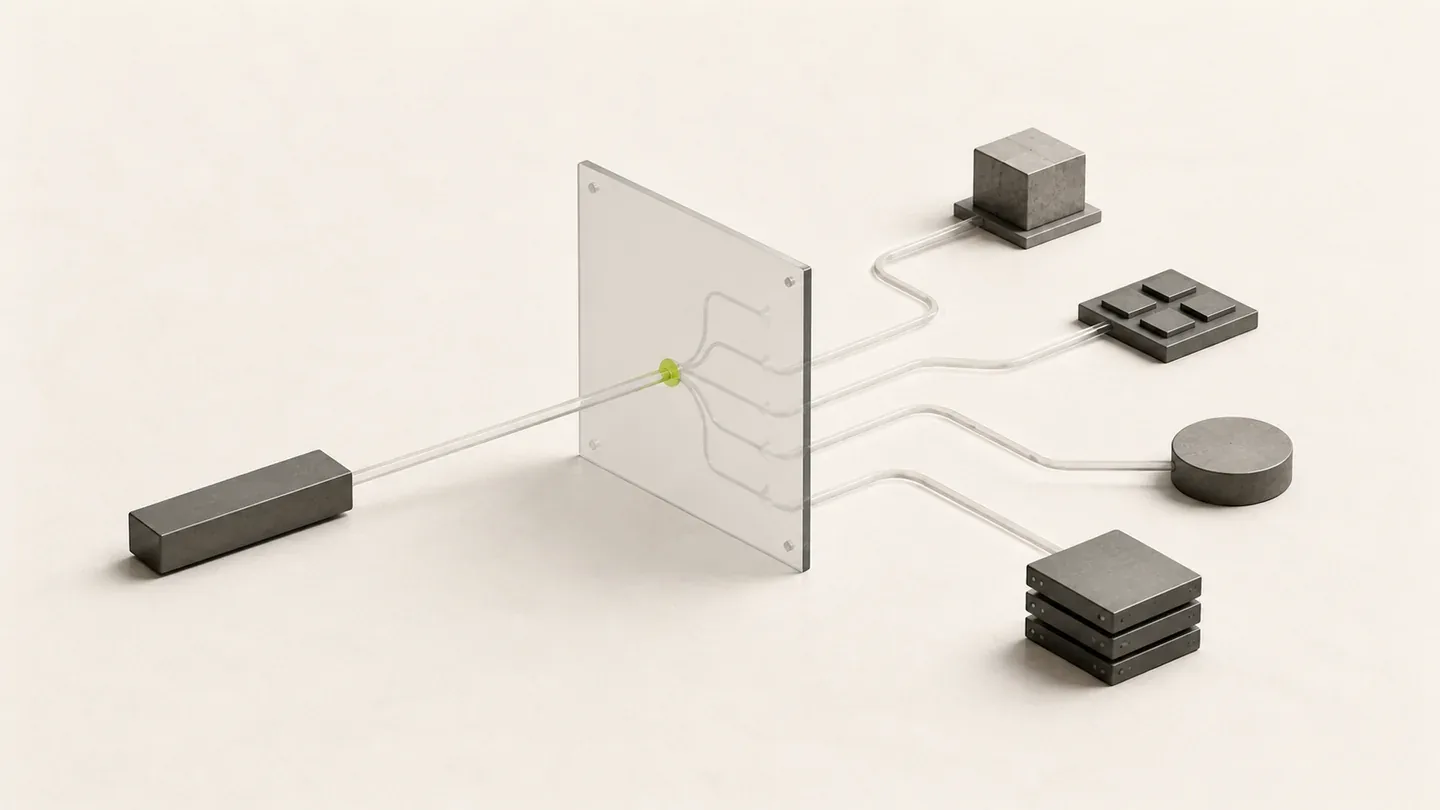
AI API ゲートウェイは、アプリケーションと 1 つ以上のモデルバックエンドの間に置かれるサービス境界です。アプリケーションはゲートウェイにリクエストを送信し、ゲートウェイは認証とアクセスポリシーを適用したうえで、リクエストされたモデルに対して条件を満たすルートを選択し、リクエストを転送して結果を記録します。
この定義は、「すべてのモデルを 1 つの API で」という説明よりも実用的です。ゲートウェイは一貫しているべき部分を一元化できますが、それによってすべてのモデルやプロバイダーが同じプロトコル、ツール、入力形式、レイテンシ特性に対応するようになるわけではありません。
AI API ゲートウェイの位置づけ
一般的なリクエストの経路は、次の 6 段階で構成されます。
| 段階 | 役割 |
|---|---|
| クライアント | モデル、プロトコル、入力、ストリーミングモードを選択する |
| 互換エンドポイント | Chat Completions や Responses など、選択された通信形式を受け付ける |
| API キーのポリシー | アカウントのアクセス権、クォータ、有効期限、モデル制限、IP ルール、ルーティング設定を確認する |
| モデルルート | リクエストの仕様を変えずに、条件を満たすモデルグループとチャネルを選択する |
| モデルバックエンド | リクエストを実行し、プロトコル固有の出力を返す |
| 利用記録 | ステータス、モデル、グループ、トークン、タイミング、コストをリクエストに関連付ける |
Modelflare の公開 Base URL は https://modelflare.dev/v1 です。クライアントは互換エンドポイントを利用でき、モデルの提供状況、プロトコルの対応状況、最新の料金はモデルと料金でいつでも確認できます。
ゲートウェイで一元化できること
認証とキーのポリシー
アプリケーションは、すべてのデプロイ先に複数のサービス提供元の認証情報を置く代わりに、1 つの Modelflare API キーを使用します。本番環境、開発環境、エージェント、自動化ごとに別々のキーを作成できるため、ワークロードごとにクォータ、有効期限、モデルへのアクセス、IP ルール、ルーティングポリシーを個別に設定できます。
モデルの確認
認証済みのモデル一覧には、現在のキーで利用可能なモデル ID が表示されます。
curl -sS https://modelflare.dev/v1/models \
  -H "Authorization: Bearer $MODELFLARE_API_KEY"
これはアクセスの確認であり、あらゆる互換性を約束するものではありません。返されたモデルも、クライアントが使用するエンドポイントと機能に対応している必要があります。
ルーティングとフォールバック
通常の API キーでは、1 つのプライマリモデルグループと、順序付きのフォールバックグループを使用できます。スマート API キー(Smart API Key)は、ルーティング方式に従って、アカウントで利用可能な具体的なグループを評価します。いずれの場合も、ルーティングが決めるのはリクエストされたモデルをどこで処理するかであり、そのモデルを知らないうちに別のモデルに置き換えるべきではありません。
本番環境での設計については、信頼性の高い AI API ルーティングを参照してください。
使用量とコストの可視化
ゲートウェイは、完了したリクエストを、選択されたモデルとグループに関連付けられます。Modelflare の利用ログにはリクエストのステータス、トークン使用量、応答時間、コストが表示されるため、運用担当者は月次の合計から推測するのではなく、個々のリクエストを調査できます。コスト計算の各層については、AI API コスト追跡で説明しています。
モデルとプロトコルに依存し続ける部分
AI API ゲートウェイを使っても、サービス提供元の仕様がなくなるわけではありません。次の境界は個別に確認してください。
- エンドポイントの対応: モデルによって、Chat Completions、Responses、Anthropic Messages、Gemini 形式のリクエストに対応している場合もあれば、その一部にしか対応していない場合もあります。
- ストリーミングイベント: Chat Completions のチャンクと Responses のイベントは、クライアントにとって別々の仕様です。
- ツールと構造化出力: スキーマや対応するツールの種類は、モデルやプロバイダーによって異なる場合があります。
- マルチモーダル入力: 画像、音声、ファイルなどの入力には、モデルとエンドポイントの明示的な対応が必要です。
- プロバイダー固有のフィールド: 一部の互換エンドポイントは、独自の制御パラメーターを変換せず、意図的にそのままパススルーします。
- レイテンシと上限: ルートが利用可能でも、すべてのバックエンドで最初の出力までの時間やリクエストの上限が同じになるわけではありません。
最も安全な移行方法は、OpenAI 互換 API ガイドから始めて、アプリケーションが実際に使う機能をそのままテストすることです。
ゲートウェイの実践的な評価
ゲートウェイの評価は、短いプロンプト 1 つではなく、実際のワークロードで行います。
- 想定するクォータとルーティングポリシーを設定した専用の API キーを作成します。
- /v1/models を取得し、そのキーで表示されるモデルを選択します。
- 最新のカタログで、対応している API 形式を確認します。
- 非ストリーミングのリクエストを 1 件送信し、返されたステータスを記録します。
- 必要に応じて、ストリーミング、ツール、構造化出力、マルチモーダル入力をそれぞれテストします。
- 生成された利用記録で、モデル、グループ、トークン、タイミング、コストを確認します。
- リクエストするモデルやプロトコルを変えずに、フォールバックの経路を試します。
- 本番環境に切り替える前に、実際に近いコンテキストサイズとクライアントのタイムアウトで再度テストします。
ゲートウェイが適しているケース
AI API ゲートウェイは、一貫したキー管理、複数のモデルファミリーへのアクセス、明示的なルーティングポリシー、一元化された利用記録、エージェントやアプリケーション向けの安定した連携境界が必要なチームに役立ちます。
一方で、互換性のあるゲートウェイの仕様が存在しないプロバイダー独自の機能にアプリケーションが依存している場合や、プロバイダーの認証情報、ルーティング、精算、診断をチーム自身で管理したい場合は、プロバイダーと直接連携するほうが適していることもあります。
判断のポイントは、抽象的に「ゲートウェイかプロバイダーか」を選ぶことではありません。ワークロードに必要なプロトコルと機能を正確に維持しながら、アクセス、ルーティング、根拠の記録にかかる運用の複雑さを減らせるかどうかです。
よくある質問
ゲートウェイを 1 つにすると、すべてのモデルで同じリクエスト形式を使えますか?
いいえ。ゲートウェイは複数の互換形式を提供できますが、クライアント、エンドポイント、モデル、サービス提供元が 1 つの仕様で一致している必要があります。既存のリクエストを Chat Completions と Responses の間で切り替える前に、カタログを確認してください。
フォールバックでは、自動的に別のモデルが選ばれますか?
Modelflare のフォールバックグループは、リクエストされたモデルを処理するためのルートです。任意のモデルに置き換えるための指示ではありません。どの候補グループも、リクエストに必要な同じモデルとプロトコルの機能を提供している必要があります。
本番環境に移行する前に、何を測定すべきですか?
認証の成否、モデルへのアクセス、非ストリーミングの出力、ストリーミングで最初の有効な出力が届くまでの時間、合計応答時間、使用量、コスト、失敗時の動作を測定します。ヘルスチェック用のプロンプトが成功しただけでは、本番環境での互換性は証明できません。