Qu’est-ce qu’une passerelle API d’IA ?
Découvrez comment une passerelle API d’IA centralise authentification, accès aux modèles, routage, repli, utilisation et coûts sans masquer les limites des protocoles.
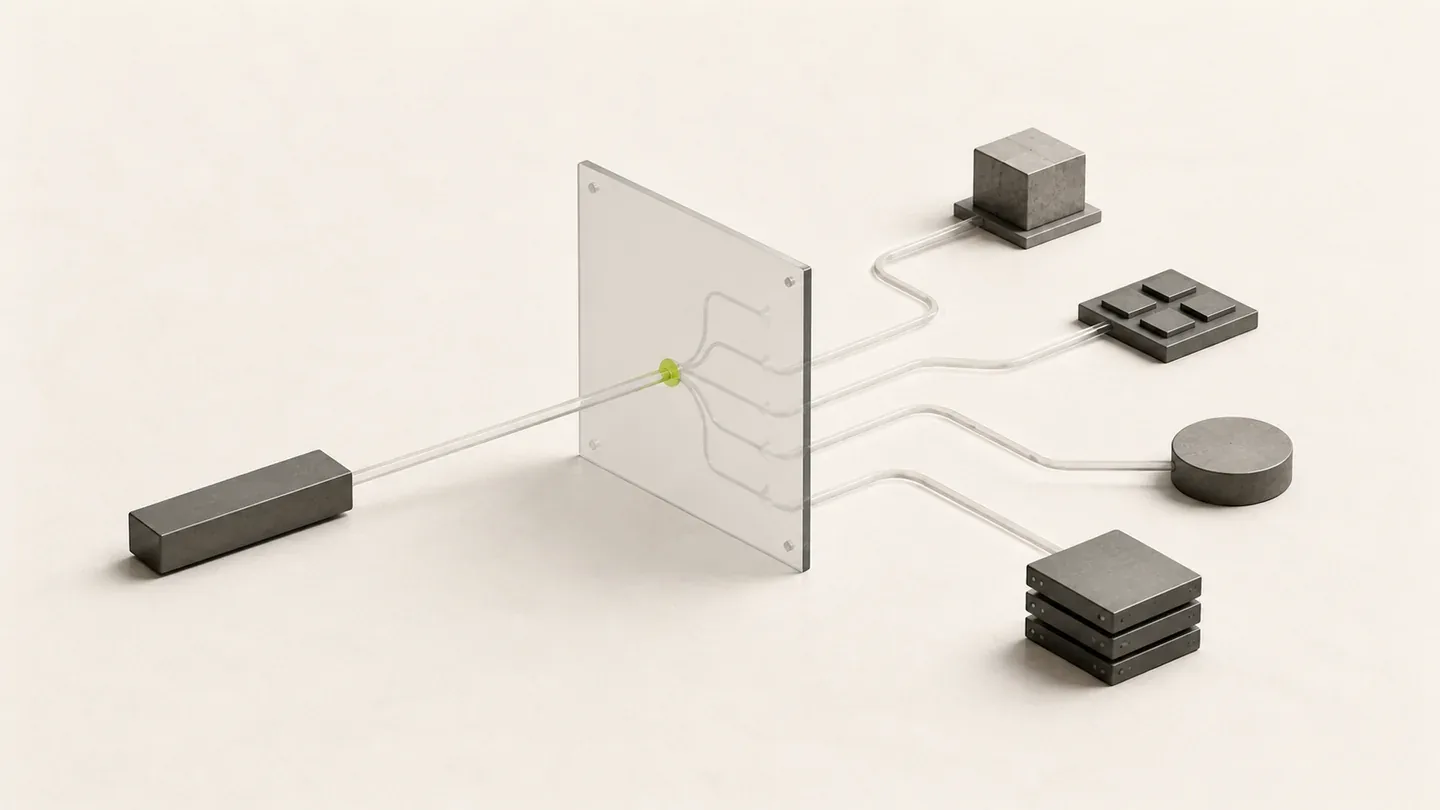
Une passerelle API d’IA est une frontière de service entre une application et un ou plusieurs backends de modèles. L’application envoie une requête à la passerelle ; la passerelle applique l’authentification et la politique d’accès, sélectionne une route éligible pour le modèle demandé, transmet la requête et enregistre le résultat.
Cette définition est plus utile que la formule « une seule API pour tous les modèles ». Une passerelle peut centraliser ce qui doit rester cohérent, mais elle ne fait pas en sorte que chaque modèle ou fournisseur prenne en charge le même protocole, les mêmes outils, les mêmes types d’entrée ou le même profil de latence.
La place d’une passerelle API d’IA
Le parcours type d’une requête comporte six étapes :
| Étape | Responsabilité |
|---|---|
| Client | Choisit le modèle, le protocole, l’entrée et le mode de streaming |
| Endpoint compatible | Accepte le format d’échange choisi, par exemple Chat Completions ou Responses |
| Politique de la clé API | Vérifie l’accès du compte, le quota, l’expiration, les limites de modèles, les règles IP et la configuration du routage |
| Route du modèle | Sélectionne un groupe de modèles et un canal éligibles sans modifier le contrat demandé |
| Backend du modèle | Exécute la requête et renvoie une sortie propre au protocole |
| Enregistrement d’utilisation | Relie le statut, le modèle, le groupe, les tokens, les mesures temporelles et le coût à la requête |
Chez Modelflare, l’URL de base publique est https://modelflare.dev/v1. Les clients peuvent utiliser des endpoints compatibles, tandis que la disponibilité des modèles, la prise en charge des protocoles et les prix en vigueur restent consultables dans Modèles et tarifs.
Ce qu’une passerelle peut centraliser
Authentification et politique des clés
Les applications utilisent une seule clé API Modelflare au lieu d’intégrer les identifiants de plusieurs fournisseurs amont dans chaque déploiement. Des clés distinctes peuvent être créées pour la production, le développement, les agents et l’automatisation, afin que chaque charge de travail dispose de son propre quota, de sa propre expiration, de son accès aux modèles, de ses règles IP et de sa politique de routage.
Découverte des modèles
La liste des modèles obtenue avec authentification indique les ID de modèle disponibles pour la clé actuelle :
curl -sS https://modelflare.dev/v1/models \
  -H "Authorization: Bearer $MODELFLARE_API_KEY"
Il s’agit d’une vérification d’accès, pas d’une promesse de compatibilité universelle. Un modèle renvoyé doit encore prendre en charge l’endpoint et les fonctionnalités utilisés par le client.
Routage et repli
Une clé API classique peut utiliser un groupe de modèles principal et des groupes de repli ordonnés. Une clé API intelligente (Smart API Key) évalue les groupes concrets disponibles pour le compte selon sa stratégie de routage. Dans les deux cas, le routage choisit l’endroit où le modèle demandé est servi ; il ne doit pas remplacer discrètement ce modèle par un autre.
Pour une conception adaptée à la production, consultez Routage fiable des API d’IA.
Visibilité sur l’utilisation et les coûts
Une passerelle peut relier la requête terminée au modèle et au groupe sélectionnés. Les journaux d’utilisation de Modelflare indiquent le statut de la requête, l’utilisation des tokens, les temps de réponse et le coût, ce qui permet à un opérateur d’examiner une requête précise au lieu de procéder par estimation à partir d’un total mensuel. Les couches de comptabilisation sont décrites dans Suivi des coûts des API d’IA.
Ce qui reste propre au modèle et au protocole
Une passerelle API d’IA n’efface pas le contrat du fournisseur amont. Vérifiez séparément ces limites :
- Prise en charge des endpoints : un modèle peut prendre en charge Chat Completions, Responses, Anthropic Messages, des requêtes de type Gemini, ou seulement une partie d’entre eux.
- Événements de streaming : les fragments Chat Completions et les événements Responses sont deux contrats client différents.
- Outils et sortie structurée : les schémas et les types d’outils pris en charge peuvent varier selon le modèle et le fournisseur.
- Entrées multimodales : les images, l’audio, les fichiers et les autres entrées nécessitent une prise en charge explicite par le modèle et l’endpoint.
- Champs propres au fournisseur : certains endpoints compatibles transmettent volontairement des réglages privés tels quels au lieu de les traduire.
- Latence et limites : la disponibilité d’une route ne signifie pas que tous les backends partagent le même délai de première sortie ou la même limite de requêtes.
La migration la plus sûre commence par le guide de l’API compatible OpenAI et teste précisément les fonctionnalités utilisées par l’application.
Évaluer une passerelle en pratique
Évaluez une passerelle avec la charge de travail réelle, et non avec un seul prompt court :
- Créez une clé API dédiée avec le quota et la politique de routage prévus.
- Récupérez /v1/models et sélectionnez un modèle visible pour cette clé.
- Confirmez le format d’API pris en charge dans le catalogue.
- Envoyez une requête sans streaming et conservez le statut renvoyé.
- Testez séparément le streaming, les outils, la sortie structurée et les entrées multimodales si nécessaire.
- Examinez l’enregistrement d’utilisation obtenu : modèle, groupe, tokens, mesures temporelles et coût.
- Testez le repli sans changer le modèle ni le protocole demandés.
- Recommencez avec une taille de contexte et des délais d’expiration client représentatifs avant la bascule en production.
Quand une passerelle est adaptée
Une passerelle API d’IA est utile lorsqu’une équipe a besoin d’une gestion cohérente des clés, d’un accès à plusieurs familles de modèles, d’une politique de routage explicite, d’enregistrements d’utilisation centralisés ou d’une frontière d’intégration stable pour ses agents et ses applications.
Une intégration directe avec un fournisseur peut rester pertinente lorsqu’une application dépend d’une fonctionnalité exclusive à ce fournisseur, sans contrat compatible côté passerelle, ou lorsque l’équipe souhaite délibérément gérer elle-même les identifiants des fournisseurs, le routage, le règlement et le diagnostic.
La question n’est pas « passerelle ou fournisseur » dans l’absolu. Il s’agit de savoir si la passerelle préserve exactement le protocole et les fonctionnalités dont la charge de travail a besoin, tout en réduisant la complexité opérationnelle liée à l’accès, au routage et à la traçabilité.
Questions fréquentes
Une passerelle unique signifie-t-elle que tous les modèles utilisent le même format de requête ?
Non. Une passerelle peut exposer plusieurs formats compatibles, mais le client, l’endpoint, le modèle et le fournisseur amont doivent toujours s’accorder sur un même contrat. Consultez le catalogue avant de faire passer une requête existante de Chat Completions à Responses, ou inversement.
Le repli choisit-il automatiquement un autre modèle ?
Les groupes de repli de Modelflare sont des routes pour le modèle demandé. Ils ne constituent pas une instruction de substitution par un modèle arbitraire. Chaque groupe candidat doit exposer le même modèle et les mêmes capacités de protocole que celles requises par la requête.
Que faut-il mesurer avant la production ?
Mesurez le taux de réussite de l’authentification, l’accès au modèle, la sortie sans streaming, la première sortie effective en streaming, le temps de réponse total, l’utilisation, le coût et le comportement en cas d’échec. Un prompt de vérification d’état réussi ne prouve pas à lui seul la compatibilité en production.