¿Qué es un gateway de API de IA? Enrutamiento y uso
Descubre cómo un gateway de API de IA centraliza autenticación, acceso a modelos, enrutamiento, respaldo, registros de uso y costos sin ocultar los límites de cada protocolo.
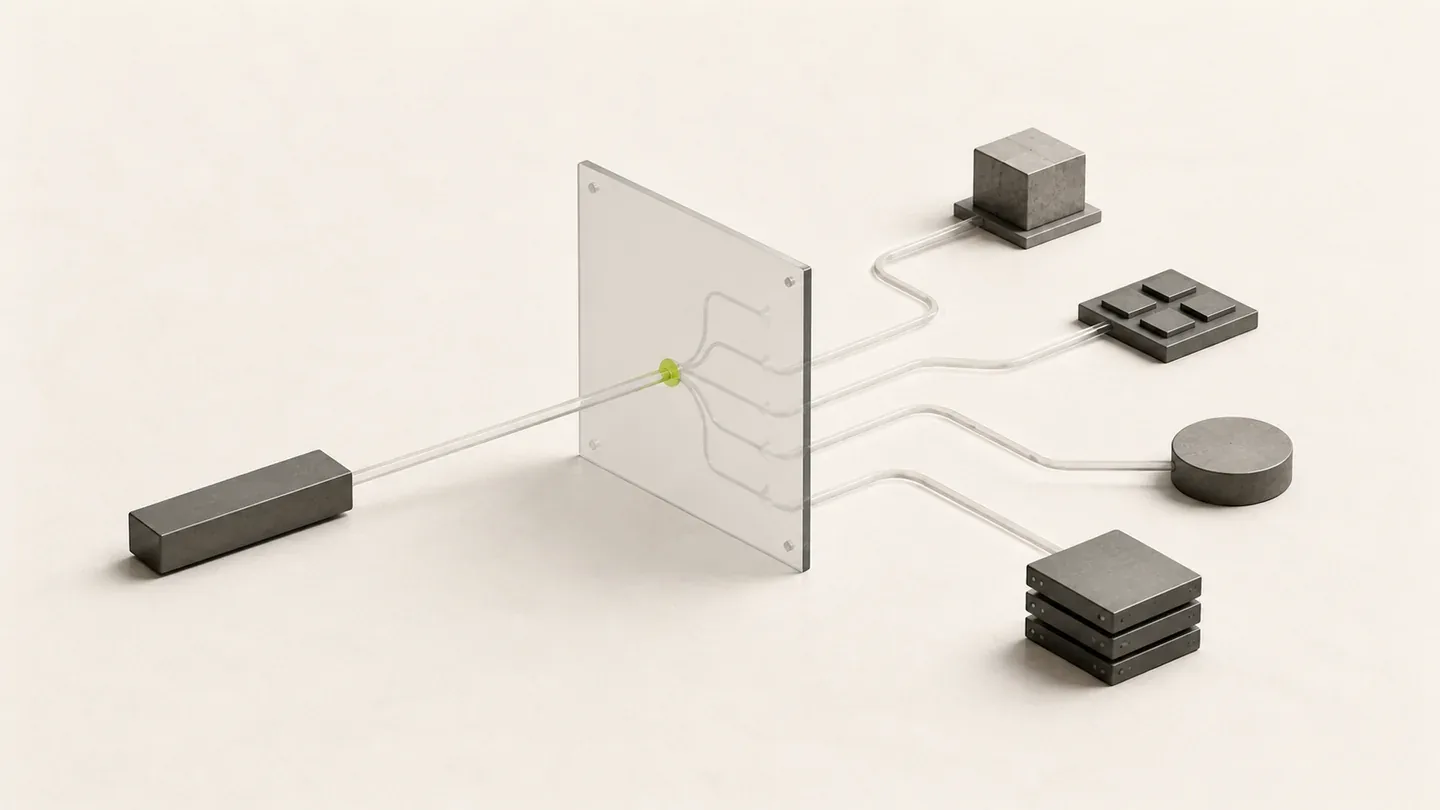
Un gateway de API de IA es una capa de servicio entre una aplicación y uno o más backends de modelos. La aplicación envía la solicitud al gateway; el gateway aplica la autenticación y la política de acceso, selecciona una ruta apta para el modelo solicitado, reenvía la solicitud y registra el resultado.
Esa definición es más útil que decir “una sola API para todos los modelos”. Un gateway puede centralizar lo que debe ser coherente, pero no hace que todos los modelos o proveedores admitan el mismo protocolo, las mismas herramientas, los mismos tipos de entrada ni el mismo perfil de latencia.
Dónde se ubica un gateway de API de IA
El recorrido típico de una solicitud tiene seis etapas:
| Etapa | Responsabilidad |
|---|---|
| Cliente | Elige el modelo, el protocolo, la entrada y el modo de streaming |
| Endpoint compatible | Acepta el formato de comunicación elegido, como Chat Completions o Responses |
| Política de la clave de API | Verifica el acceso de la cuenta, los créditos, el vencimiento, los límites de modelos, las reglas de IP y la configuración de enrutamiento |
| Ruta del modelo | Selecciona un grupo de modelos y un canal aptos sin cambiar el contrato solicitado |
| Backend del modelo | Ejecuta la solicitud y devuelve la salida propia de su protocolo |
| Registro de uso | Vincula a la solicitud el estado, el modelo, el grupo, los tokens, los tiempos y el costo |
En Modelflare, la URL base pública es https://modelflare.dev/v1. Los clientes pueden usar endpoints compatibles y consultar en Modelos y precios la disponibilidad de modelos, los protocolos admitidos y los precios vigentes.
Qué puede centralizar un gateway
Autenticación y política de claves
Las aplicaciones usan una sola clave de API de Modelflare en lugar de incluir varias credenciales de proveedores en cada despliegue. Puedes crear claves separadas para producción, desarrollo, agentes y automatización, de modo que cada carga de trabajo tenga sus propios créditos, vencimiento, acceso a modelos, reglas de IP y política de enrutamiento.
Descubrimiento de modelos
La lista autenticada de modelos muestra los ID de modelo disponibles para la clave actual:
curl -sS https://modelflare.dev/v1/models \
  -H "Authorization: Bearer $MODELFLARE_API_KEY"
Esto es una verificación de acceso, no una promesa de compatibilidad universal. Un modelo devuelto aún debe admitir el endpoint y las funciones que usa el cliente.
Enrutamiento y respaldo
Una clave de API normal puede usar un grupo de modelos principal y grupos de respaldo ordenados. Una clave de API inteligente (Smart API Key) evalúa los grupos concretos disponibles para la cuenta según su estrategia de enrutamiento. En ambos casos, el enrutamiento decide dónde se atiende el modelo solicitado; no debe reemplazarlo sin aviso por otro modelo.
Para el diseño en producción, consulta enrutamiento confiable de API de IA.
Visibilidad del uso y del costo
Un gateway puede vincular la solicitud completada con el modelo y el grupo seleccionados. Los registros de uso de Modelflare muestran el estado de la solicitud, el uso de tokens, los tiempos de respuesta y el costo, para que un operador pueda investigar una solicitud concreta en lugar de hacer estimaciones a partir de un total mensual. Las capas de contabilidad se describen en control de costos de API de IA.
Qué sigue dependiendo del modelo y del protocolo
Un gateway de API de IA no elimina el contrato del proveedor. Verifica estos límites por separado:
- Endpoints admitidos: un modelo puede admitir Chat Completions, Responses, Anthropic Messages, solicitudes al estilo de Gemini o solo algunos de ellos.
- Eventos de streaming: los fragmentos de Chat Completions y los eventos de Responses son contratos de cliente diferentes.
- Herramientas y salida estructurada: los esquemas y los tipos de herramientas admitidos pueden variar según el modelo y el proveedor.
- Entrada multimodal: las imágenes, el audio, los archivos y otras entradas requieren que el modelo y el endpoint los admitan explícitamente.
- Campos específicos del proveedor: algunos endpoints compatibles reenvían controles privados sin cambios de forma intencional, en lugar de traducirlos.
- Latencia y límites: que una ruta esté disponible no hace que todos los backends tengan el mismo tiempo hasta la primera salida ni el mismo límite de solicitudes.
La migración más segura empieza con la guía de API compatible con OpenAI y prueba exactamente las funciones que usa la aplicación.
Una evaluación práctica del gateway
Evalúa un gateway con la carga de trabajo real, no con un prompt corto:
- Crea una clave de API dedicada con los créditos y la política de enrutamiento previstos.
- Consulta /v1/models y selecciona un modelo visible para esa clave.
- Confirma en el catálogo en vivo el formato de API admitido.
- Envía una solicitud sin streaming y conserva el estado devuelto.
- Si las necesitas, prueba por separado el streaming, las herramientas, la salida estructurada y la entrada multimodal.
- Revisa el registro de uso resultante: modelo, grupo, tokens, tiempos y costo.
- Prueba la ruta de respaldo sin cambiar el modelo ni el protocolo solicitados.
- Repite con un tamaño de contexto y tiempos de espera del cliente representativos antes del cambio a producción.
Cuándo conviene un gateway
Un gateway de API de IA es útil cuando un equipo necesita una administración de claves coherente, acceso a varias familias de modelos, una política de enrutamiento explícita, registros de uso centralizados o una frontera de integración estable para agentes y aplicaciones.
Una integración directa con el proveedor puede seguir siendo adecuada cuando una aplicación depende de una función exclusiva del proveedor que no tiene un contrato compatible en el gateway, o cuando el equipo quiere administrar por su cuenta las credenciales, el enrutamiento, la liquidación y el diagnóstico con el proveedor.
La decisión no es “gateway o proveedor” en abstracto. Se trata de si el gateway conserva exactamente el protocolo y las funciones que necesita la carga de trabajo, mientras reduce la complejidad operativa del acceso, el enrutamiento y la evidencia.
Preguntas frecuentes
¿Un solo gateway significa que todos los modelos usan el mismo formato de solicitud?
No. Un gateway puede exponer varios formatos compatibles, pero el cliente, el endpoint, el modelo y el proveedor deben coincidir en un mismo contrato. Revisa el catálogo antes de cambiar una solicitud existente de Chat Completions a Responses, o al revés.
¿El respaldo elige automáticamente otro modelo?
Los grupos de respaldo de Modelflare son rutas para el modelo solicitado. No son una instrucción para sustituirlo por un modelo cualquiera. Cada grupo candidato debe ofrecer el mismo modelo y las capacidades de protocolo que requiere la solicitud.
¿Qué conviene medir antes de pasar a producción?
Mide el éxito de la autenticación, el acceso al modelo, la salida sin streaming, la primera salida efectiva en streaming, el tiempo total de respuesta, el uso, el costo y el comportamiento ante fallas. Que funcione un prompt de verificación de estado no demuestra, por sí solo, la compatibilidad en producción.