Was ist ein KI-API-Gateway? Routing & Nutzung
Erfahren Sie, wie ein KI-API-Gateway Authentifizierung, Modellzugriff, Routing, Fallback, Nutzungsdaten und Kosten bündelt, ohne Protokollgrenzen zu verbergen.
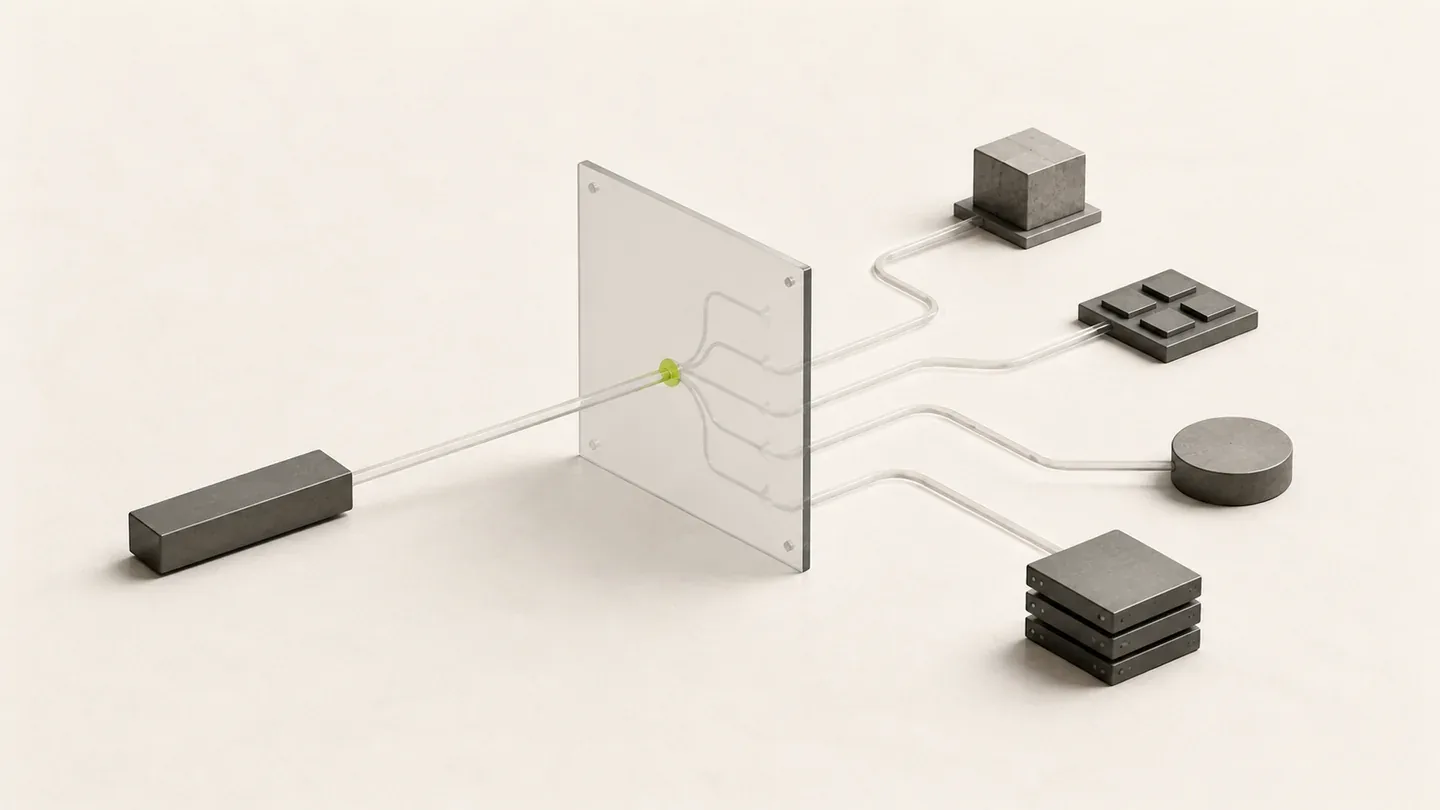
Ein KI-API-Gateway ist eine Dienstgrenze zwischen einer Anwendung und einem oder mehreren Modell-Backends. Die Anwendung sendet eine Anfrage an das Gateway; das Gateway wendet Authentifizierung und Zugriffsrichtlinie an, wählt eine geeignete Route für das angeforderte Modell aus, leitet die Anfrage weiter und erfasst das Ergebnis.
Diese Definition ist hilfreicher als „eine API für alle Modelle“. Ein Gateway kann die Teile zentralisieren, die einheitlich sein sollten, sorgt aber nicht dafür, dass jedes Modell und jeder Anbieter dasselbe Protokoll, dieselben Tools, dieselben Eingabetypen oder dasselbe Latenzprofil unterstützt.
Wo ein KI-API-Gateway sitzt
Ein typischer Anfragepfad hat sechs Stufen:
| Stufe | Verantwortung |
|---|---|
| Client | Wählt Modell, Protokoll, Eingabe und Streaming-Modus |
| Kompatibler Endpunkt | Nimmt das gewählte Protokollformat an, etwa Chat Completions oder Responses |
| Richtlinie des API-Schlüssels | Prüft Kontozugriff, Kontingent, Ablaufdatum, Modellgrenzen, IP-Regeln und Routing-Konfiguration |
| Modellroute | Wählt eine geeignete Modellgruppe und einen Kanal, ohne den angeforderten Vertrag zu ändern |
| Modell-Backend | Führt die Anfrage aus und liefert protokollspezifische Ausgabe |
| Nutzungsdatensatz | Verknüpft Status, Modell, Gruppe, Token, Zeiten und Kosten mit der Anfrage |
Bei Modelflare lautet die öffentliche Basis-URL https://modelflare.dev/v1. Clients können kompatible Endpunkte nutzen, während Modellverfügbarkeit, Protokollunterstützung und aktuelle Preise unter Modelle & Preise einsehbar bleiben.
Was ein Gateway zentralisieren kann
Authentifizierung und Schlüsselrichtlinie
Anwendungen verwenden einen Modelflare-API-Schlüssel, statt die Zugangsdaten mehrerer Dienstanbieter in jedes Deployment zu legen. Für Produktion, Entwicklung, Agenten und Automatisierung lassen sich separate Schlüssel erstellen, sodass jede Arbeitslast ihr eigenes Kontingent, Ablaufdatum, ihren eigenen Modellzugriff, eigene IP-Regeln und eine eigene Routing-Richtlinie hat.
Modellermittlung
Die authentifizierte Modellliste zeigt die Modell-IDs, die für den aktuellen Schlüssel verfügbar sind:
curl -sS https://modelflare.dev/v1/models \
  -H "Authorization: Bearer $MODELFLARE_API_KEY"
Das ist eine Zugriffsprüfung, keine universelle Kompatibilitätszusage. Ein zurückgegebenes Modell muss weiterhin den Endpunkt und die Funktionen unterstützen, die der Client nutzt.
Routing und Fallback
Ein regulärer API-Schlüssel kann eine primäre Modellgruppe und geordnete Fallback-Gruppen verwenden. Ein Smart-API-Schlüssel (Smart API Key) bewertet die konkreten, für das Konto verfügbaren Gruppen gemäß seiner Routing-Strategie. In beiden Fällen entscheidet das Routing, wo das angeforderte Modell bereitgestellt wird; es sollte dieses Modell nicht unbemerkt durch ein anderes ersetzen.
Hinweise zum Design für den Produktivbetrieb finden Sie unter Zuverlässiges KI-API-Routing.
Transparenz über Nutzung und Kosten
Ein Gateway kann die abgeschlossene Anfrage mit dem ausgewählten Modell und der ausgewählten Gruppe verknüpfen. Die Nutzungsprotokolle von Modelflare zeigen Anfragestatus, Token-Nutzung, Antwortzeiten und Kosten, sodass Betreiber eine einzelne Anfrage untersuchen können, statt aus einer Monatssumme zu schätzen. Die Abrechnungsebenen sind unter KI-API-Kostenverfolgung beschrieben.
Was modell- und protokollspezifisch bleibt
Ein KI-API-Gateway hebt den Vertrag des Dienstanbieters nicht auf. Prüfen Sie diese Grenzen separat:
- Endpunktunterstützung: Ein Modell unterstützt möglicherweise Chat Completions, Responses, Anthropic Messages, Anfragen im Gemini-Stil oder nur einen Teil davon.
- Streaming-Events: Chat-Completions-Chunks und Responses-Events sind unterschiedliche Client-Verträge.
- Tools und strukturierte Ausgabe: Schemas und unterstützte Tool-Typen können je nach Modell und Anbieter variieren.
- Multimodale Eingaben: Bilder, Audio, Dateien und andere Eingaben erfordern ausdrückliche Unterstützung durch Modell und Endpunkt.
- Anbieterspezifische Felder: Manche kompatiblen Endpunkte reichen private Steuerfelder bewusst durch, statt sie zu übersetzen.
- Latenz und Limits: Eine verfügbare Route bedeutet nicht, dass alle Backends dieselbe Zeit bis zur ersten Ausgabe oder dasselbe Anfragelimit haben.
Die sicherste Migration beginnt mit dem Leitfaden zu OpenAI-kompatiblen APIs und testet genau die Funktionen, die die Anwendung nutzt.
Ein Gateway in der Praxis bewerten
Bewerten Sie ein Gateway mit der echten Arbeitslast, nicht mit einem einzelnen kurzen Prompt:
- Erstellen Sie einen eigenen API-Schlüssel mit dem geplanten Kontingent und der geplanten Routing-Richtlinie.
- Rufen Sie /v1/models ab und wählen Sie ein Modell aus, das für diesen Schlüssel sichtbar ist.
- Bestätigen Sie das unterstützte API-Format im Live-Katalog.
- Senden Sie eine Anfrage ohne Streaming und bewahren Sie den zurückgegebenen Status auf.
- Testen Sie Streaming, Tools, strukturierte Ausgabe und multimodale Eingaben bei Bedarf separat.
- Prüfen Sie den entstandenen Nutzungsdatensatz auf Modell, Gruppe, Token, Zeiten und Kosten.
- Testen Sie den Fallback-Pfad, ohne das angeforderte Modell oder Protokoll zu ändern.
- Wiederholen Sie die Tests vor der Produktivumstellung mit repräsentativer Kontextgröße und realen Client-Timeouts.
Wann ein Gateway gut passt
Ein KI-API-Gateway ist sinnvoll, wenn ein Team eine einheitliche Schlüsselverwaltung, Zugriff auf mehrere Modellfamilien, eine explizite Routing-Richtlinie, zentrale Nutzungsdaten oder eine stabile Integrationsgrenze für Agenten und Anwendungen benötigt.
Eine direkte Anbieterintegration kann weiterhin sinnvoll sein, wenn eine Anwendung von einer anbieterexklusiven Funktion ohne kompatiblen Gateway-Vertrag abhängt oder wenn das Team Zugangsdaten, Routing, Abrechnung und Diagnose beim Anbieter bewusst selbst verantworten möchte.
Die Entscheidung lautet nicht abstrakt „Gateway oder Anbieter“. Entscheidend ist, ob das Gateway genau das Protokoll und die Funktionen erhält, die die Arbeitslast braucht, und zugleich den Betriebsaufwand für Zugriff, Routing und Nachweise verringert.
Häufige Fragen
Verwenden mit einem Gateway alle Modelle dasselbe Anfrageformat?
Nein. Ein Gateway kann mehrere kompatible Formate bereitstellen, aber Client, Endpunkt, Modell und Dienstanbieter müssen sich weiterhin auf einen Vertrag einigen. Prüfen Sie den Katalog, bevor Sie eine bestehende Anfrage zwischen Chat Completions und Responses umstellen.
Wählt ein Fallback automatisch ein anderes Modell?
Fallback-Gruppen von Modelflare sind Routen für das angeforderte Modell. Sie sind keine Anweisung, ein beliebiges anderes Modell einzusetzen. Jede Kandidatengruppe muss dasselbe Modell und dieselben Protokollfähigkeiten bereitstellen, die die Anfrage erfordert.
Was sollte vor dem Produktivbetrieb gemessen werden?
Messen Sie erfolgreiche Authentifizierung, Modellzugriff, Ausgabe ohne Streaming, erste effektive Streaming-Ausgabe, Gesamtantwortzeit, Nutzung, Kosten und Fehlerverhalten. Ein erfolgreicher Health-Check-Prompt allein beweist keine Produktionstauglichkeit.